终结“长上下文灾难”,绿算发布AI存储新范式!CES现场直击:黄仁勋刚定调,我们就有了对等方案
当AI学会“遗忘”,这不再是哲学问题,而是昂贵算力撞上存储瓶颈的现实
拉斯维加斯CES 2026现场,英伟达创始人黄仁勋一针见血地指出:“上下文是新的瓶颈,存储必须被重新架构”。随着大模型参数迈向万亿、上下文长度直指百万Token,推理过程中产生的海量键值缓存(KV Cache)正将昂贵的GPU显存压得喘不过气。
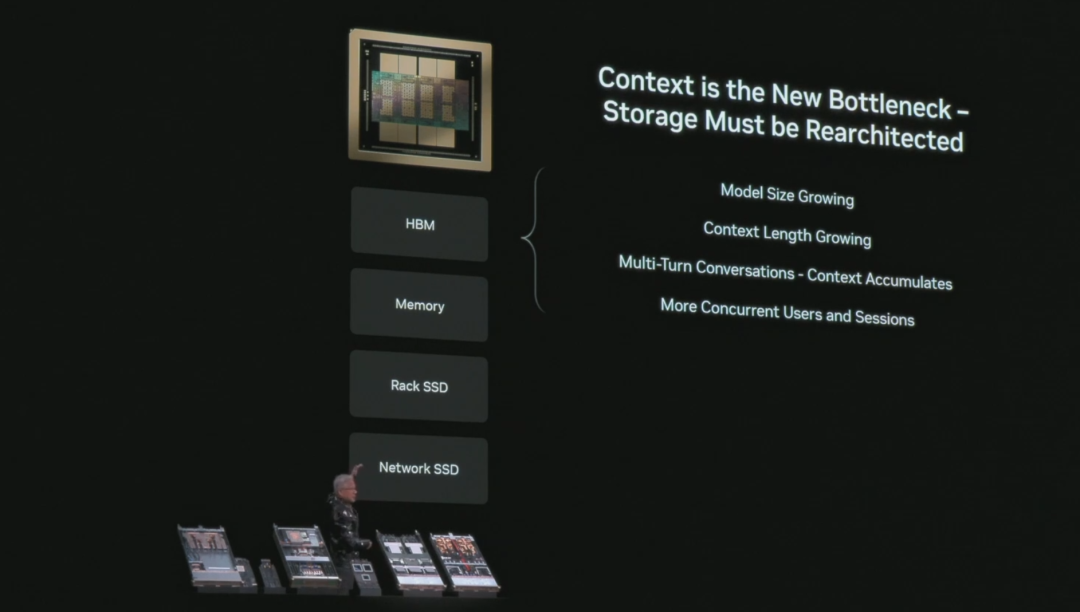
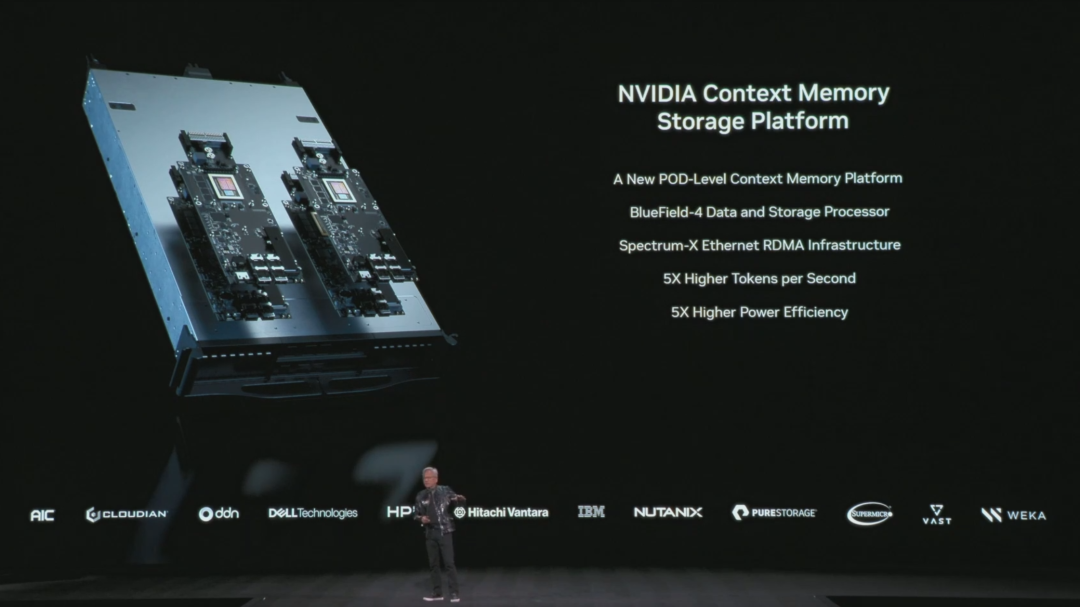
为应对挑战,英伟达推出了全新的“推理上下文内存存储平台”(Inference Context Memory Storage Platform),其核心是围绕 “HBM→DRAM→Rack SSD→Network SSD” 构建的四层存储架构,旨在为海量KV Cache(键值缓存)提供归宿。
而在地球的另一端,绿算技术几乎在同一时间发布了基于相同分层理念的解决方案。这并非巧合,而是顶尖工程思维在面对同一技术难题时产生的共鸣。双方在顶层设计上高度一致,而在最关键的性能核心——第三层(L3)的实现上,绿算方案提出了一条更为极致的路径:通过纯粹的硬件协议卸载,将网络存储的性能潜力释放到前所未有的高度。
01. 新瓶颈:上下文内存的“容量灾难”
黄仁勋在CES主题演讲中描述的困境,正在每一行推理代码中上演。
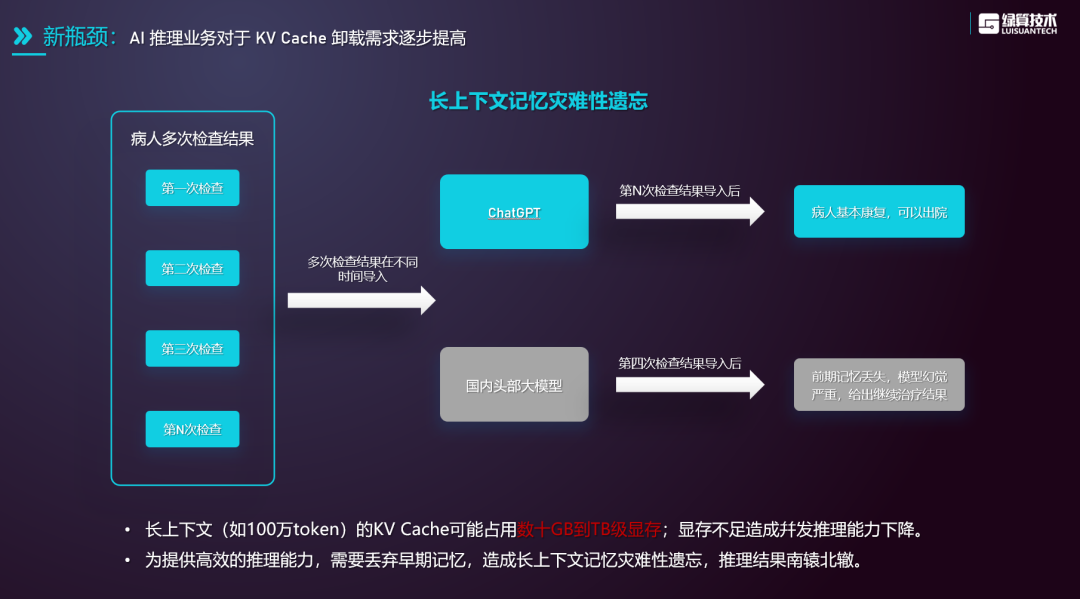
一位医生将一个病人的N次检查报告分次输入给AI模型,希望它给出综合判断。但当第四次报告输入后,由于GPU显存已满载,AI不得不“遗忘”最早期的检查结果,最终的诊断结论南辕北辙——这就是“长上下文灾难性遗忘”。
其根源在于,大模型推理生成每一个新词(Token),都依赖对之前所有上下文的记忆(KV Cache)。当处理一部小说或一份复杂的技术文档时,KV Cache的规模可达数十GB甚至TB级,远超单张或多张GPU显存的承受极限。如果无法为所有上下文提供“容身之所”,模型的“记忆力”和判断力就会急剧下降。
传统的单机存储方案无法解决这一系统性难题。为此,AI领域的先行者们不约而同地祭出了同一种应对策略:分级存储,化身为池。
02. 共识之源:为何四级存储架构成为必然?
黄仁勋在演讲中揭示的“长上下文灾难性遗忘”场景,直观地体现了现有架构的局限:当处理超长文档或多轮对话时,GPU显存无法容纳整个上下文记忆,被迫丢弃早期信息,导致推理质量下降。
其根源在于,大模型推理产生的KV Cache体积正从GB级向TB级迈进,远超昂贵显存的承载极限。要打破这一瓶颈,必须构建一个容量与性能兼顾的层次化存储系统。
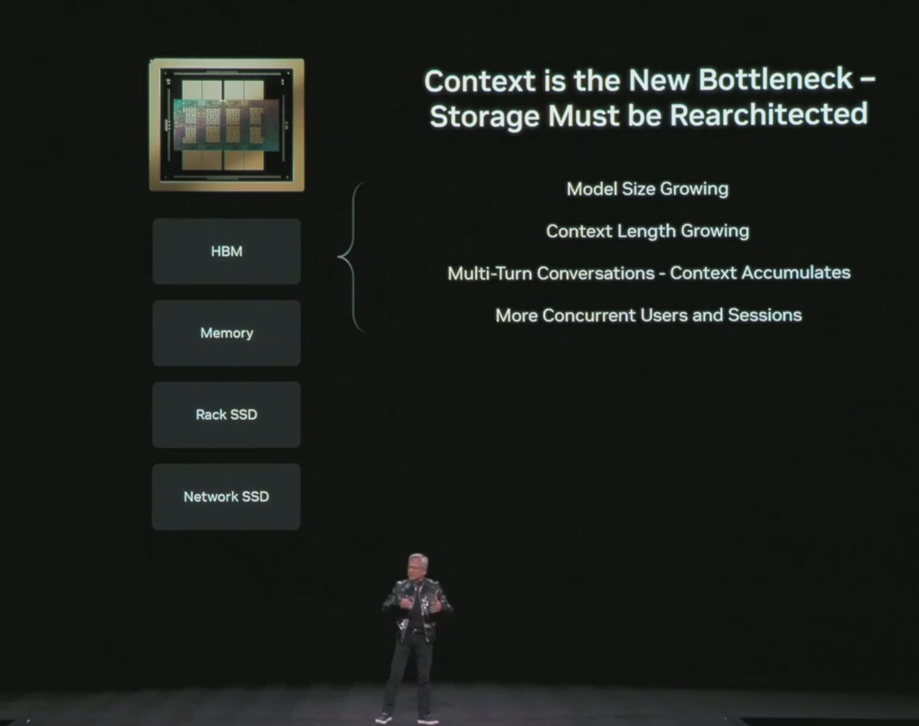
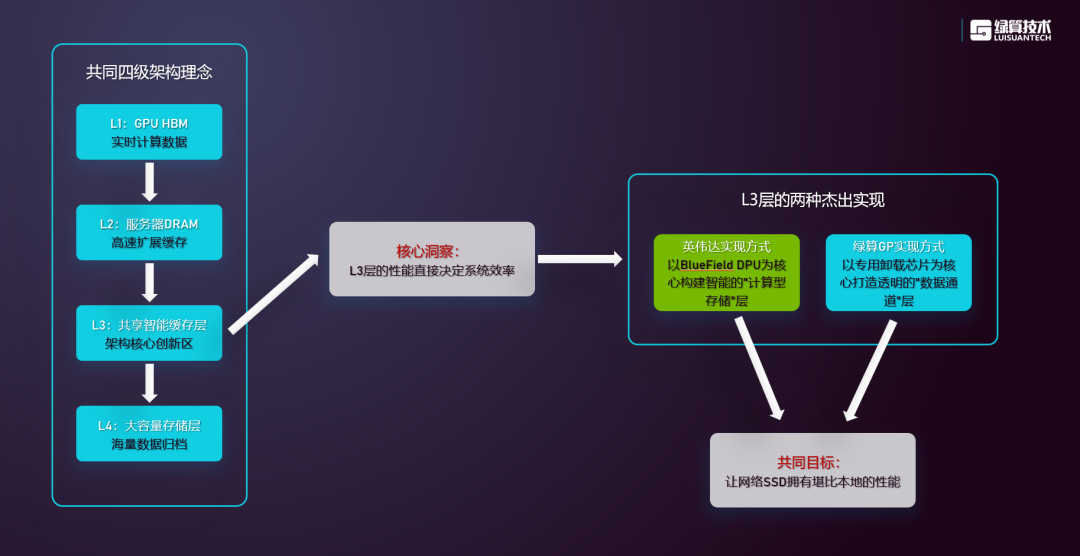
L1: GPU HBM (显存):存储最活跃、最热的KV Cache片段。
L2: 节点 DRAM (内存):作为HBM的下一级扩展缓冲区。
L3: 机架级SSD (Rack SSD):构成可扩展、共享的“上下文内存”资源池。
L4: 网络存储/对象存储 (Network/Object Storage):承载海量冷数据和模型权重。
该方案由BlueField-4 DPU作为核心存储处理器,通过Spectrum-X以太网实现高速、无损的RDMA访问,并与Dynamo推理调度软件深度集成,实现高达5倍的吞吐与能效提升。
03. 理念同频:绿算的四级架构蓝图
基于完全相同的分层理念,绿算技术描绘了结构对等的四级架构,尤其在核心的L3层,提出了一个更为专注和极致的硬件优化思路。
04. 优化核心:当网络存储获得“本地级”性能
如何让远在网络另一端的存储设备,提供堪比本地NVMe SSD的访问体验?这是L3层设计的终极挑战。
英伟达的路径是通过高度智能的DPU(数据处理单元)来管理、优化这一数据池,与自家GPU和调度器深度协同,构建一个功能强大的“存储大脑”。
而绿算GP方案则选择了一条更为纯粹和底层的“硬化”路径。其核心是一台无通用CPU、采用ASIC/FPGA实现协议全卸载的专用设备。它的设计目标单一而强悍:彻底消除网络存储访问中的软件协议栈开销。
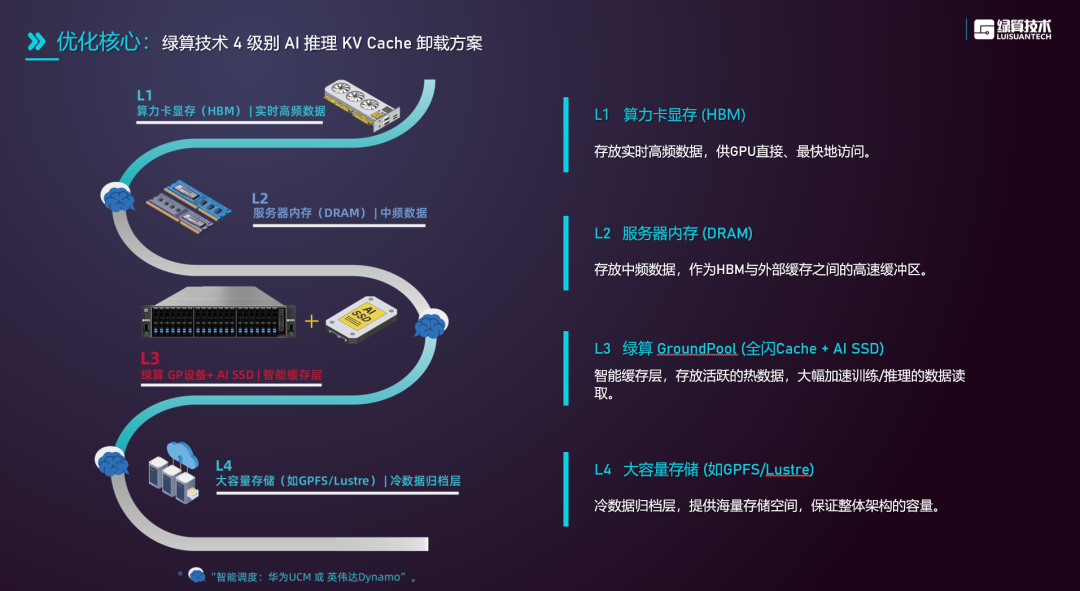
其技术关键在于:
协议卸载:将复杂的NVMe-oF网络存储协议处理,从主机CPU完全卸载到绿算GP设备的专用芯片中固化执行。
路径极简:数据通过RDMA(远程直接内存访问)技术,在GPU显存与网络SSD之间建立直接通道,实现端到端的零拷贝传输。
延迟斩除:这一硬件级的优化,将远程访问的额外延迟从毫秒级降至微秒级,使得“网络SSD如本地SSD”成为现实。
正是这种对基础瓶颈的专注攻克,使得绿算GP能够以更透明、更高效的方式,将标准商用SSD的性能发挥到极致,为AI集群提供了一个灵活、可独立扩展的顶级缓存资源池。
05. 殊途同归:为AI未来提供多元选择
黄仁勋先生的洞见为AI基础设施的发展指明了关键方向。绿算技术的方案则证明,在这一清晰的方向上,通过深耕底层的硬件卸载技术,能够为业界提供一种性能极致且架构开放的优秀选择。
这不仅是技术的进步,更是生态的丰富。它意味着,无论客户处于何种技术栈,都能找到匹配自身需求的解决方案,以应对即将到来的、拥有真正“长记忆”的AI时代。伟大的思想引领方向,而多元的实现共同铺就通往未来的道路。