AI Inference
智算中心 · AI 推理加速
KV Cache 卸载 · GPU 利用率提升至 94%
项目背景
面向大模型推理场景,显存成为系统瓶颈:KV Cache 占用大量 HBM,导致单卡可承载的上下文长度有限、GPU 利用率偏低。
解决方案
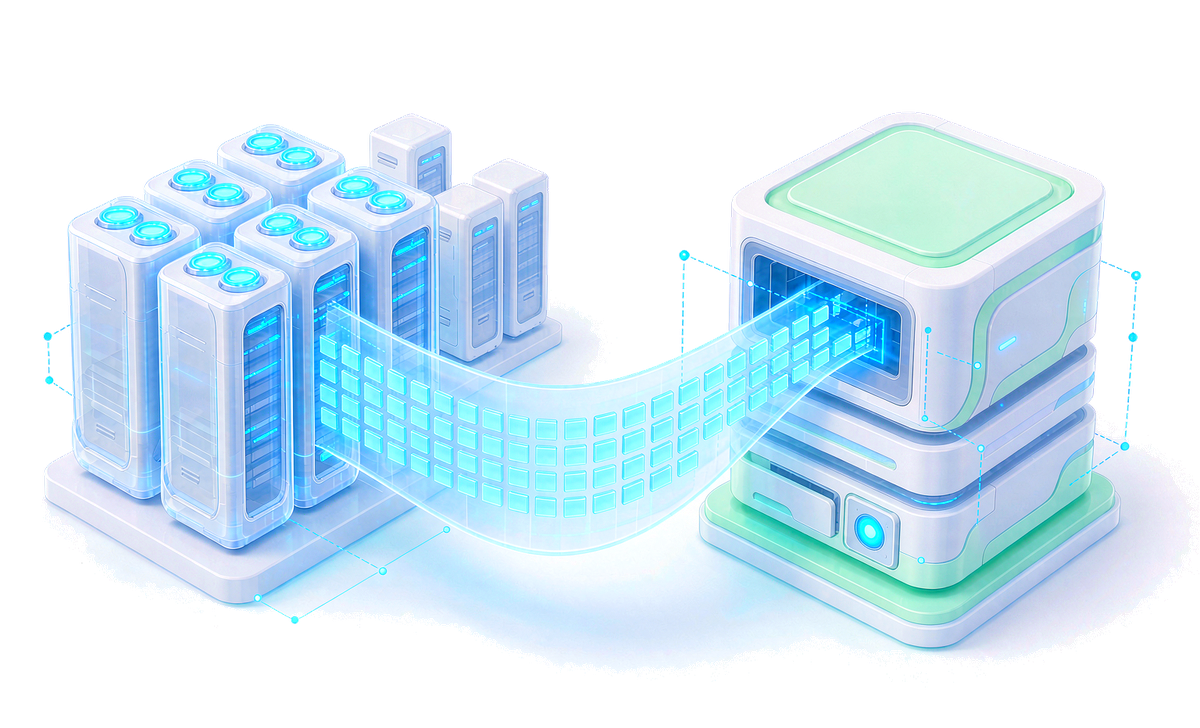
采用 GP7000 G3.5(CMX)存储平台,通过全硬件卸载将 KV Cache 迁移到以太网闪存簇(JBOF/EBOF),让 GPU 专注令牌生成。
- <20μs 微秒级延迟,接近内存访问体验
- GPU 利用率提升至 94% 以上
- 上下文重算比例从 80–90% 降至 10% 以下
- 原生兼容 Dynamo 调度与 NIXL 传输库
落地价值
在保持精度的前提下显著提升单机并发与吞吐,降低单位 Token 的推理成本,支撑大规模商用部署。