Solidigm联合绿算技术共同发布《面向 SOHO AI 推理的存储扩展方案》技术白皮书
内容摘要:随着大语言模型向长上下文、多轮会话、RAG 以及 Agent 应用持续演进,KV Cache 已逐渐成为影响 AI 推理系统容量、成本和扩展能力的重要因素。对于面向个人开发者、小型团队和企业边缘部署场景的 NVIDIA DGX Spark 而言,本地存储容量限制使 KV Cache 的长期保存和大规模扩展面临挑战。
本文提出一种基于绿算技术存储节点与Solidigm NVMe SSD 的存储扩展方案,通过 RDMA 网络将远程 NVMe 存储资源接入 DGX Spark,为 KV Cache Offload 提供可扩展的存储容量。该方案采用计算与存储分离的架构设计,在保持本地推理能力的同时,实现 KV Cache 容量的独立扩展与集中管理。
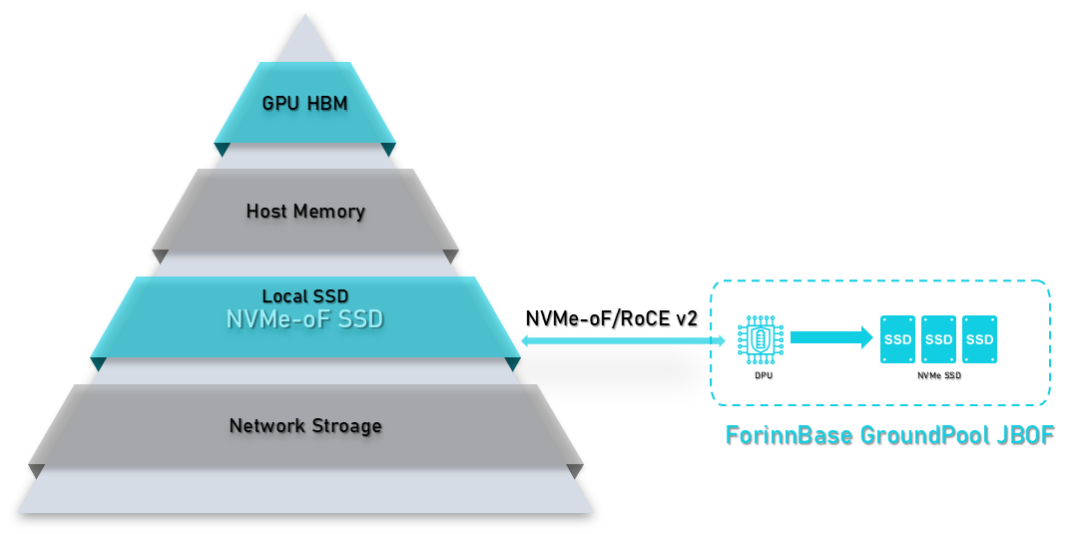
在该分层缓存架构中,HBM 提供最高性能,DRAM 提供更大容量,本地 SSD 用于 KV Cache Offload,网络存储进一步扩展缓存空间。测试结果表明,采用绿算技术存储节点构建的 RDMA 存储池能够在提供更大 KV Cache 容量的同时保持与本地 NVMe SSD 相当的端到端推理性能——远程 JBOF 方案在 TTFT 和系统吞吐量指标上未观察到明显性能损失,部分场景下表现优于本地存储配置。
方案架构
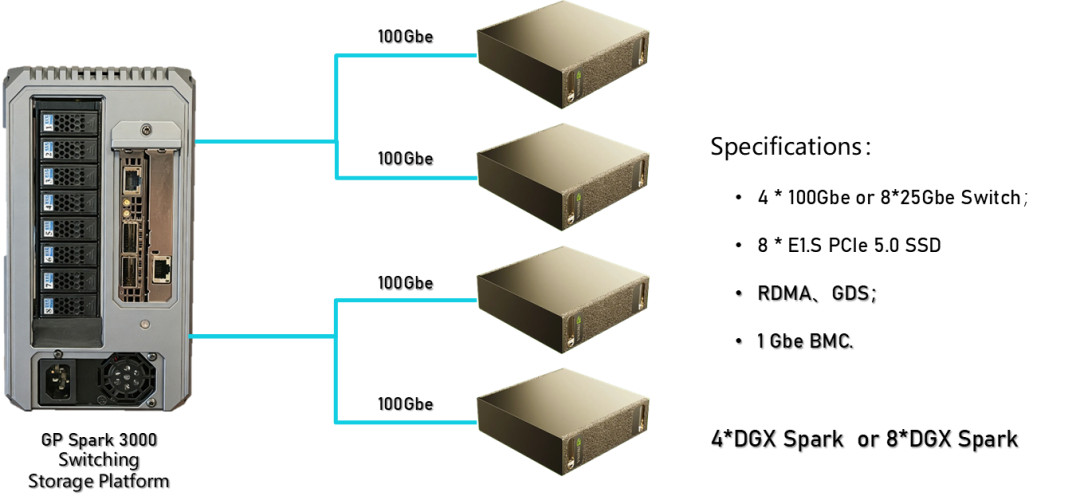
方案基于计算与存储分离的架构设计。通过在 DGX Spark 之外引入绿算技术 GP Spark 3000 存储节点和 Solidigm D7-PS1010 NVMe SSD,构建基于 RDMA 网络的共享存储池,为 KV Cache 提供独立扩展和集中管理的容量基础。
绿算技术 GP Spark 存储
绿算技术 GP Spark 3000 交换存储平台是一款面向AI集群场景的交换式存储设备,最多支持8台DGX Spark共享统一NVMe-oF存储资源池。硬件上搭载NVIDIA BlueField-3 DPU,配备4个100GbE或8个25GbE交换端口、8块E1.S PCIe 5.0 SSD及1GbE BMC管理接口,单机实现266万IOPS、50GB/s吞吐,端到端延迟低于20微秒,功耗控制在200W以内。其核心价值在于打破传统多机集群中的"缓存孤岛"问题——任何Prefill节点写入的缓存,任何Decode节点均能以不超过20微秒延迟直接读取,P99延迟降低78%,Cache命中率提升39%,整体TCO下降30%以上。
Solidigm D7-PS1010 PCIe Gen5 NVMe SSD
本方案采用 Solidigm D7-PS1010 企业级 NVMe SSD 作为 KV Cache Offload 的底层存储介质。D7-PS1010 基于 PCIe Gen5 x4 接口和 TLC NAND 设计,E1.S 规格容量可达 7.68 TB,顺序读取带宽最高 14.5 GB/s,随机读取最高 330 万 IOPS,提供 1 DWPD 企业级耐久度与 2.5 Million Hours MTBF,满足长期运行 AI 推理平台对数据完整性和系统稳定性的要求。
远端存储性能测试
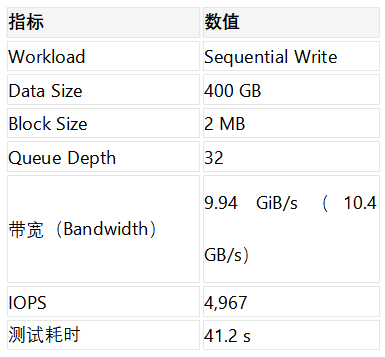
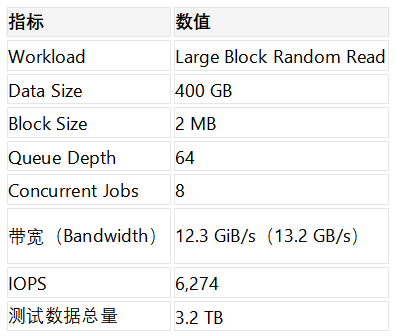
测试采用 fio 对存储池进行验证,以 2 MB Block Size 模拟 KV Cache Chunk 的实际存储形态:先顺序写入 400 GB 数据模拟 KV Cache 持久化过程,再随机读取相同数据集模拟缓存恢复和加载过程。所有测试均通过 RDMA 网络访问远端 JBOF 存储资源。
KV Cache 持久化性能
测试结果显示,远端存储实现了 9.94 GiB/s(10.4 GB/s)的持续写入带宽,仅用约 41 秒即可完成全部 400 GB 数据写入。
KV Cache 加载性能
读取测试中,远端 JBOF 存储能够提供 12.3 GiB/s(13.2 GB/s)的读取带宽,在高并发场景下仍保持稳定的数据吞吐能力。测试表明基于 RDMA 的存储架构能够有效降低远端访问带来的性能影响,使远端 NVMe SSD 具备接近本地存储设备的访问能力。
KV Cache Offload 推理性能验证
基于 vLLM 与 LMCache 环境(Qwen3-1.7B 模型),采用 KV Cache Tester 分别在本地 SSD 和远端 JBOF 两种配置下开展验证,重点对比 TTFT(Time to First Token)与系统吞吐量。
Single Prompt 测试
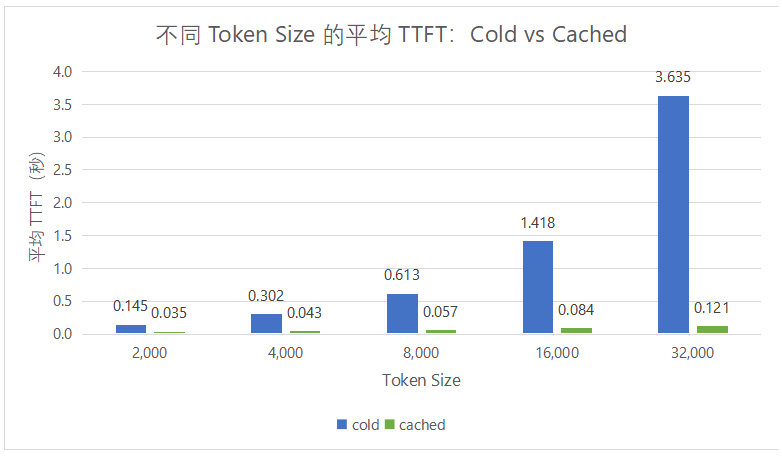
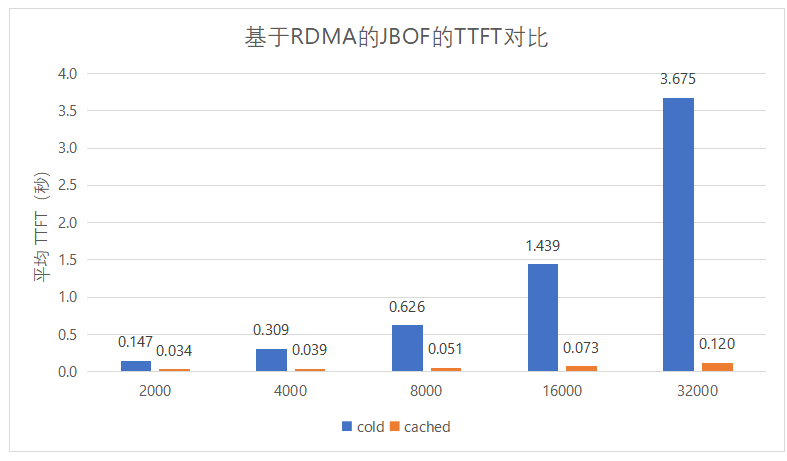
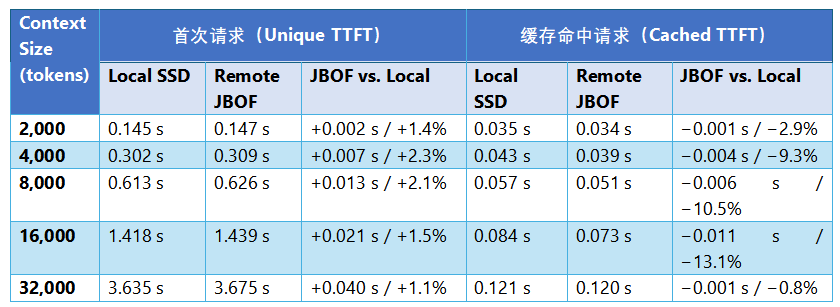
测试覆盖 2,000 至 32,000 tokens 五种上下文长度。结果显示:首次请求 TTFT 差异仅为 +1.1% 至 +2.3%;缓存命中请求中,远端 JBOF 的 TTFT 均不高于本地 SSD,差异范围为 −0.8% 至 −13.1%。
Cache Hit Rate 测试
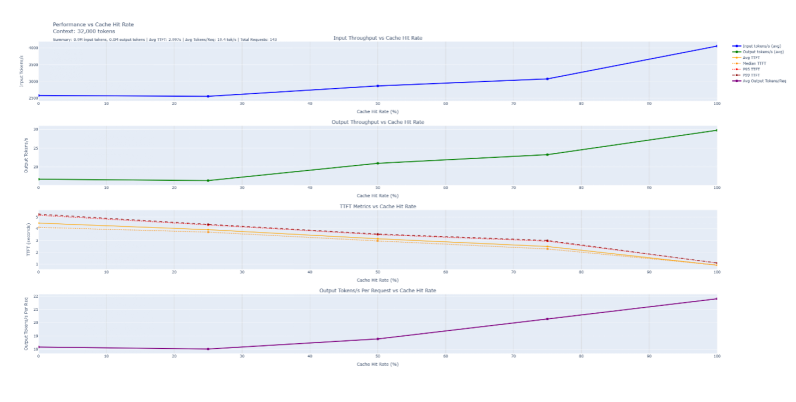
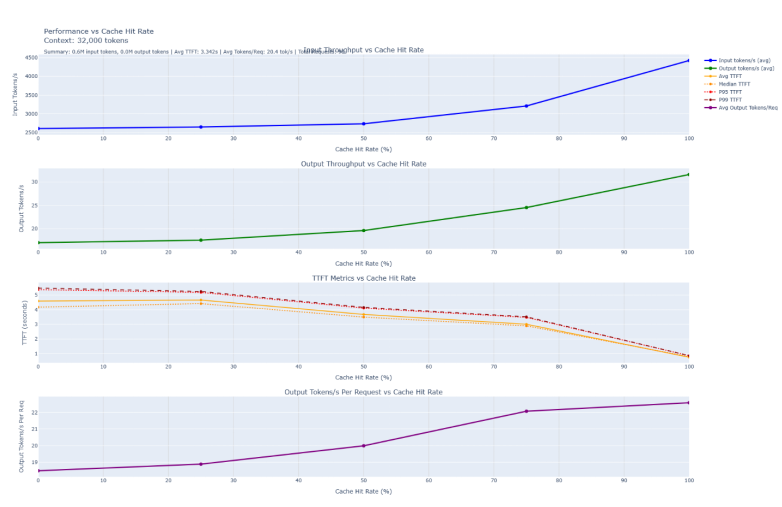
将上下文长度固定为 32,000 tokens,以 10% 为步长调整缓存命中率。在模型、上下文长度及其他推理参数均一致的条件下,本地 SSD 与远端 RDMA JBOF 各项性能指标未呈现明显差异。
本地 SSD 测试结果
RDMA JBOF 测试结果
总结与展望
本文验证了基于 RDMA 网络的远端存储在 AI KV Cache Offload 场景中的可行性:与本地高性能 SSD 相比,远端存储所引入的性能开销较小,整体端到端推理性能基本处于同一水平。作为面向边缘侧和SOHO AI场景的存储扩展方案,该架构在保持 DGX Spark 紧凑部署形态与本地推理能力的同时,为 KV Cache 提供了独立扩展和集中管理的容量基础。
未来,随着长上下文、多轮会话、RAG 和多 Agent 协作工作负载持续增长,共享远端存储还可进一步支持跨节点的 Prefix Cache、Session Cache 以及 Agent Memory 复用,为小型团队和边缘部署构建更具扩展性的 AI 推理基础设施提供新的实现路径。
Reference