ASC 2026 | 把 KV Cache 从内存下沉一层,代价到底是多少
10月21日下午,2026 先进存力大会(ASC)存储系统专题现场,绿算技术有限公司市场营销管理中心总经理黄飞受邀出席,并作《KV Cache 分层落点对比——不是 DRAM 买不起,NVMe-oF 更有性价比》主题演讲。
这不是一场讲趋势的演讲。他带上去的是一份已经跑完的实测报告:在绿算 GP7000 全闪 NVMe-oF 存储阵列上,用真实的推理引擎、真实的长会话负载,把同一份 KV Cache 分别放在"纯 DRAM"和"DRAM + 全闪"两个位置,逐项对比。
结论被拆成三个问题——代价、换来、结果。
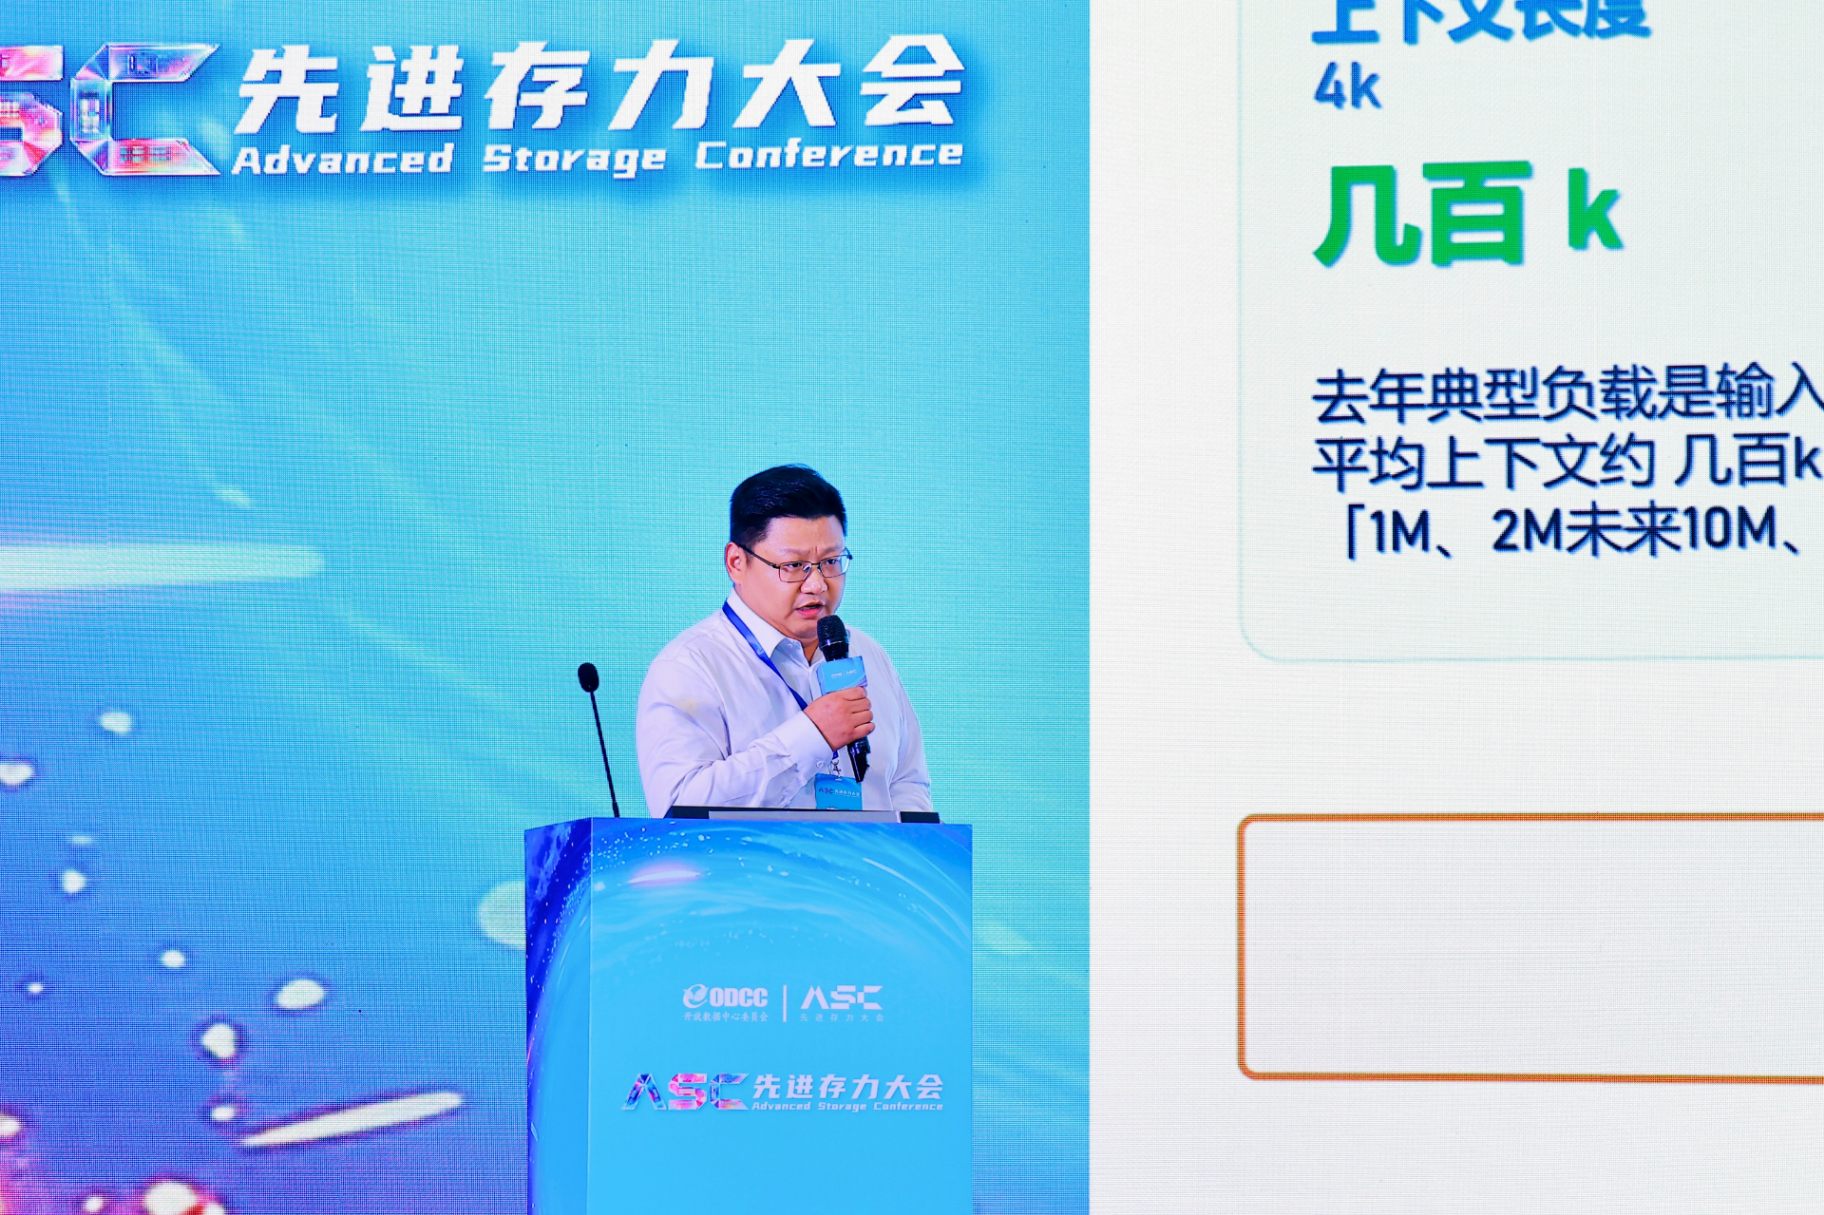
图:2026 先进存力大会(ASC)现场,绿算技术市场营销管理中心总经理黄飞作主题演讲
大会背景:一场把"存力"摆到台面上的会
2026 先进存力大会(ASC)由开放数据中心委员会(ODCC)主办,10 月 21 日至 22 日在上海召开。大会议程以"存力向新"为主线,设存储部件、存储系统、存算网协同三个专题论坛,汇聚产学研各界专家,围绕先进存力发展趋势、AI 存储架构变革与存算网融合实践展开交流。
开幕式上,上海市经济和信息化委员会信息基础设施管理处处长祁超表示,上海已围绕算力布局、算存协同、存储应用等开展多项工作,未来将进一步强化存力技术攻关与场景应用,深化产学研用交流合作;中国信通院正高级工程师郭亮指出,存储在 AI 时代面临新的机遇和挑战,对先进存力的研究越来越重要,ODCC 长期深耕计算、存储、网络等 IT 设施的研究与创新。
大会期间,三项产业动作同时落地:
- 存算网创新联合体正式启动,聚焦共性关键技术攻关、开源生态共建与规模商用示范;
- 先进存力实验室正式成立,围绕部件、系统和存算网协同,开展技术研究、标准体系建设及联合测试验证;
- "算力强基揭榜行动"存力方向领雁计划同步启动,面向跨域存力协同、多介质融合存储等方向打造标杆项目,加速攻关成果规模化推广。
10 月 21 日下午的存储系统专题论坛,由中国移动项目经理冯轶主持。腾讯、博通、惠鑫天空、天翼云、中国移动、绿算技术、华为、中国信通院的专家依次登台,围绕统一存储、高速存算互联、磁光电融合、大模型全流程存储、跨算力中心存力调度、KV Cache 分层等议题展开交流;圆桌环节,腾讯、博通、华为、中国移动的专家进一步围绕产业实践、技术适配痛点与创新方向做了研讨。
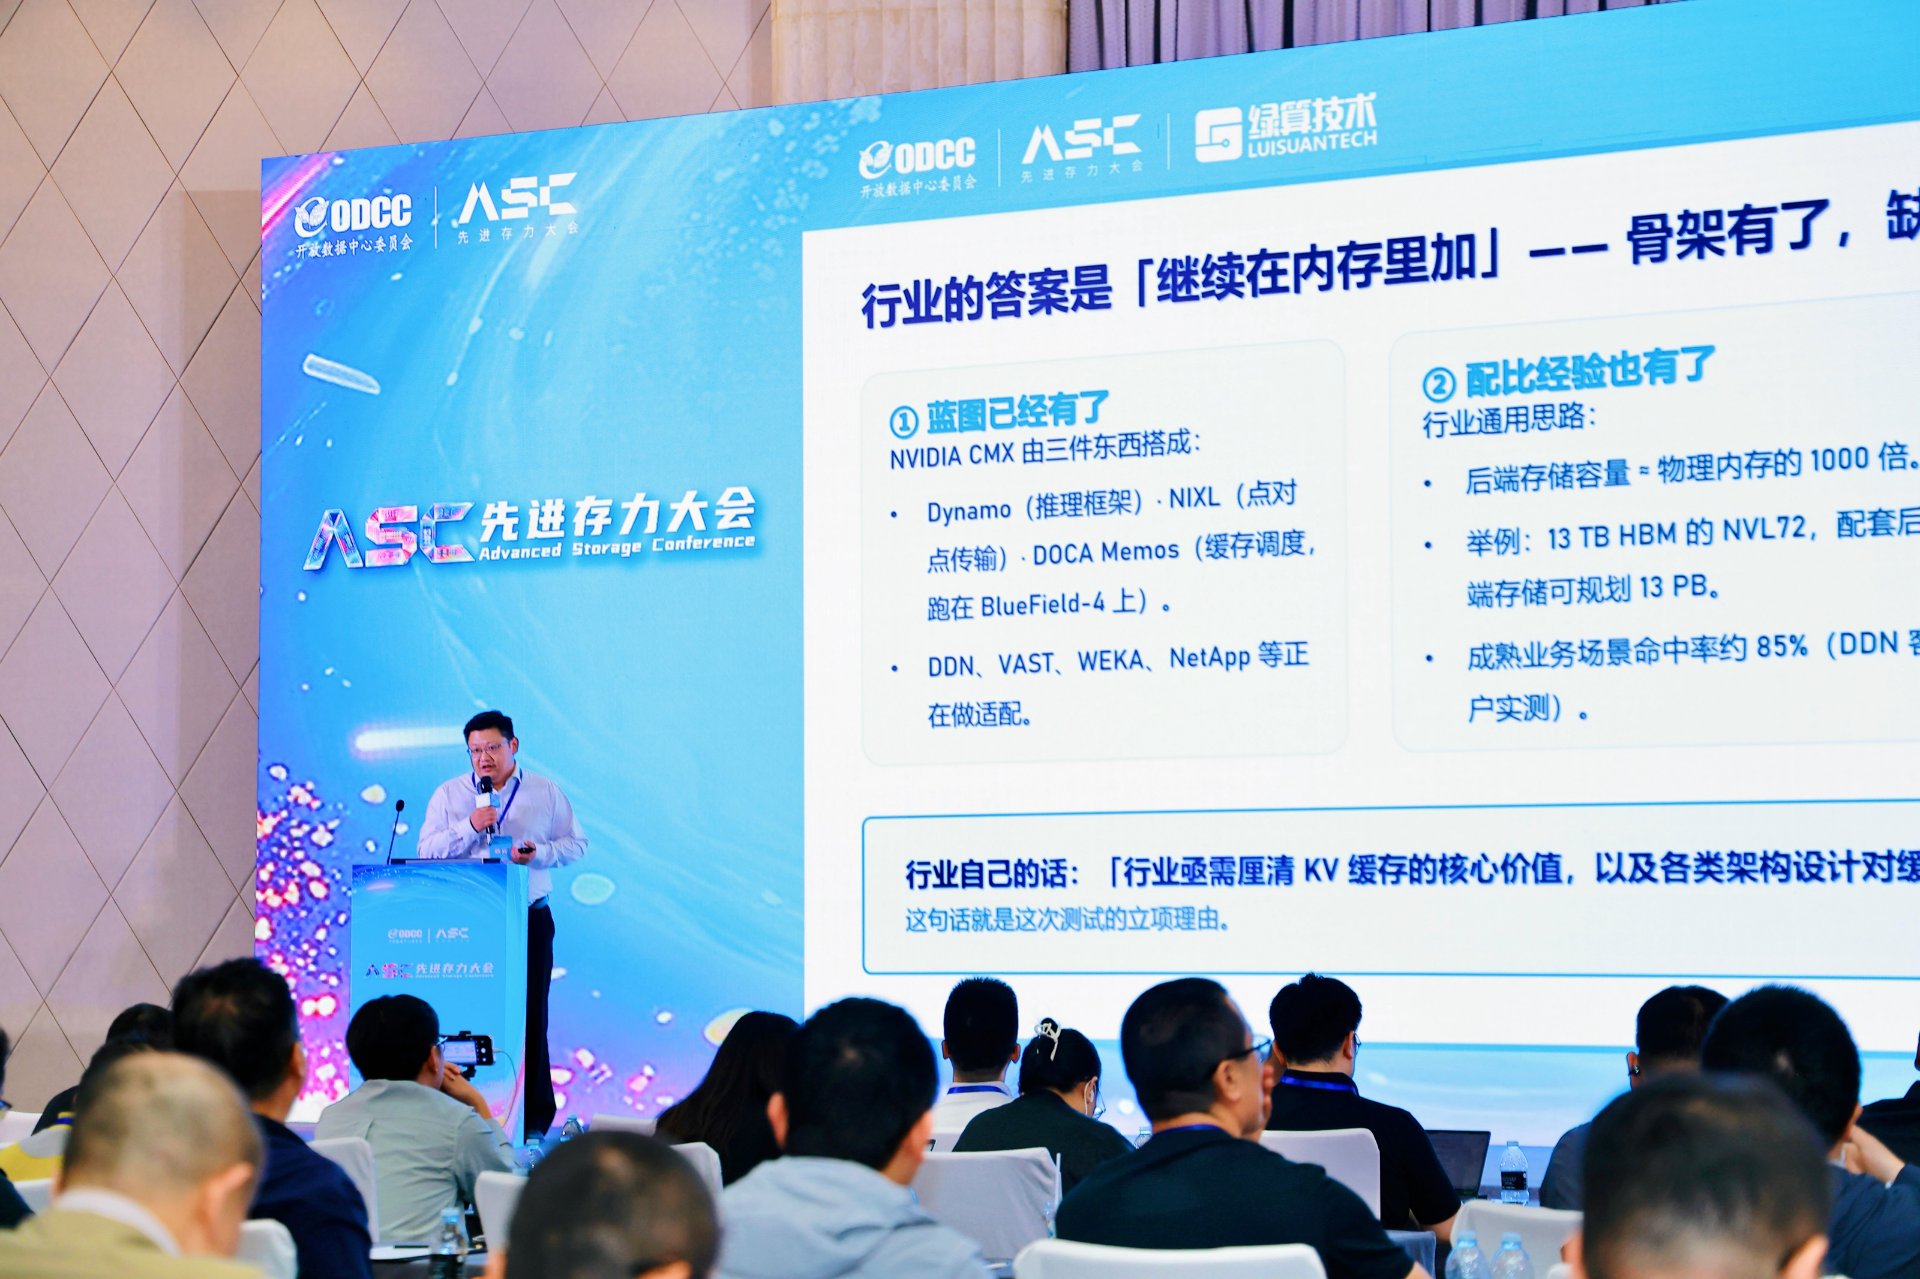
图:黄飞在存储系统专题论坛现场演讲
这个问题的性质,在过去一年变了
开场没有直接讲介质,而是先讲负载。
去年:典型负载是输入 4k、输出 1k,一问一答;考核标准是"答得多快"。
今年:平均上下文已经到几百 k,而且还在涨——「1M、2M 未来 10M、百 M 都有可能」;负载形态从一次问答变成几十轮任务,长输入、多轮次、强复用同时压过来;考核标准也随之改写,从"一次答得多快"变成"一个任务能否连续、稳定、低成本地完成"。
三件事叠加,指向同一个结论:
KV Cache 的容量,从"优化项"变成了"能不能跑完的项"。
这不是一个新话题,但它的分量变了。
三类客户,卡在同一个地方
为什么会变?因为过去一年里,三类看起来完全不同的客户,先后撞上了同一堵墙。
运营商:政务客服、智能助手,长会话聊到一二十轮就越来越慢,客户投诉随之而来。能想到的办法只有加内存,但加到某个值,还是会某一轮被打穿。
云与互联网:他们自己就建了缓存池,懂行、也盯长尾。第一反应通常是"我内存够大"——唯一没解决的问题是:再大也会满。
AI 大模型企业:写代码助手、工具调用,五十轮起步,单个会话几十万字。重复计算在烧 GPU,到第 20 轮,每个请求要重算近 10 万个 token。
他们的问题不是"读得慢",是"装不下"。
一句话,把行业里长期跑偏的讨论方向掰了回来。
行业有蓝图,缺的是一块实测
"继续在内存里加",这是行业给出的答案。黄飞没有否定它,而是指出它缺了哪一块。
蓝图已经有了。NVIDIA CMX 由三件东西搭成:Dynamo 负责推理框架,NIXL 负责点对点传输,DOCA Memos 负责缓存调度、跑在 BlueField-4 上;DDN、VAST、WEKA、NetApp 等正在做适配。
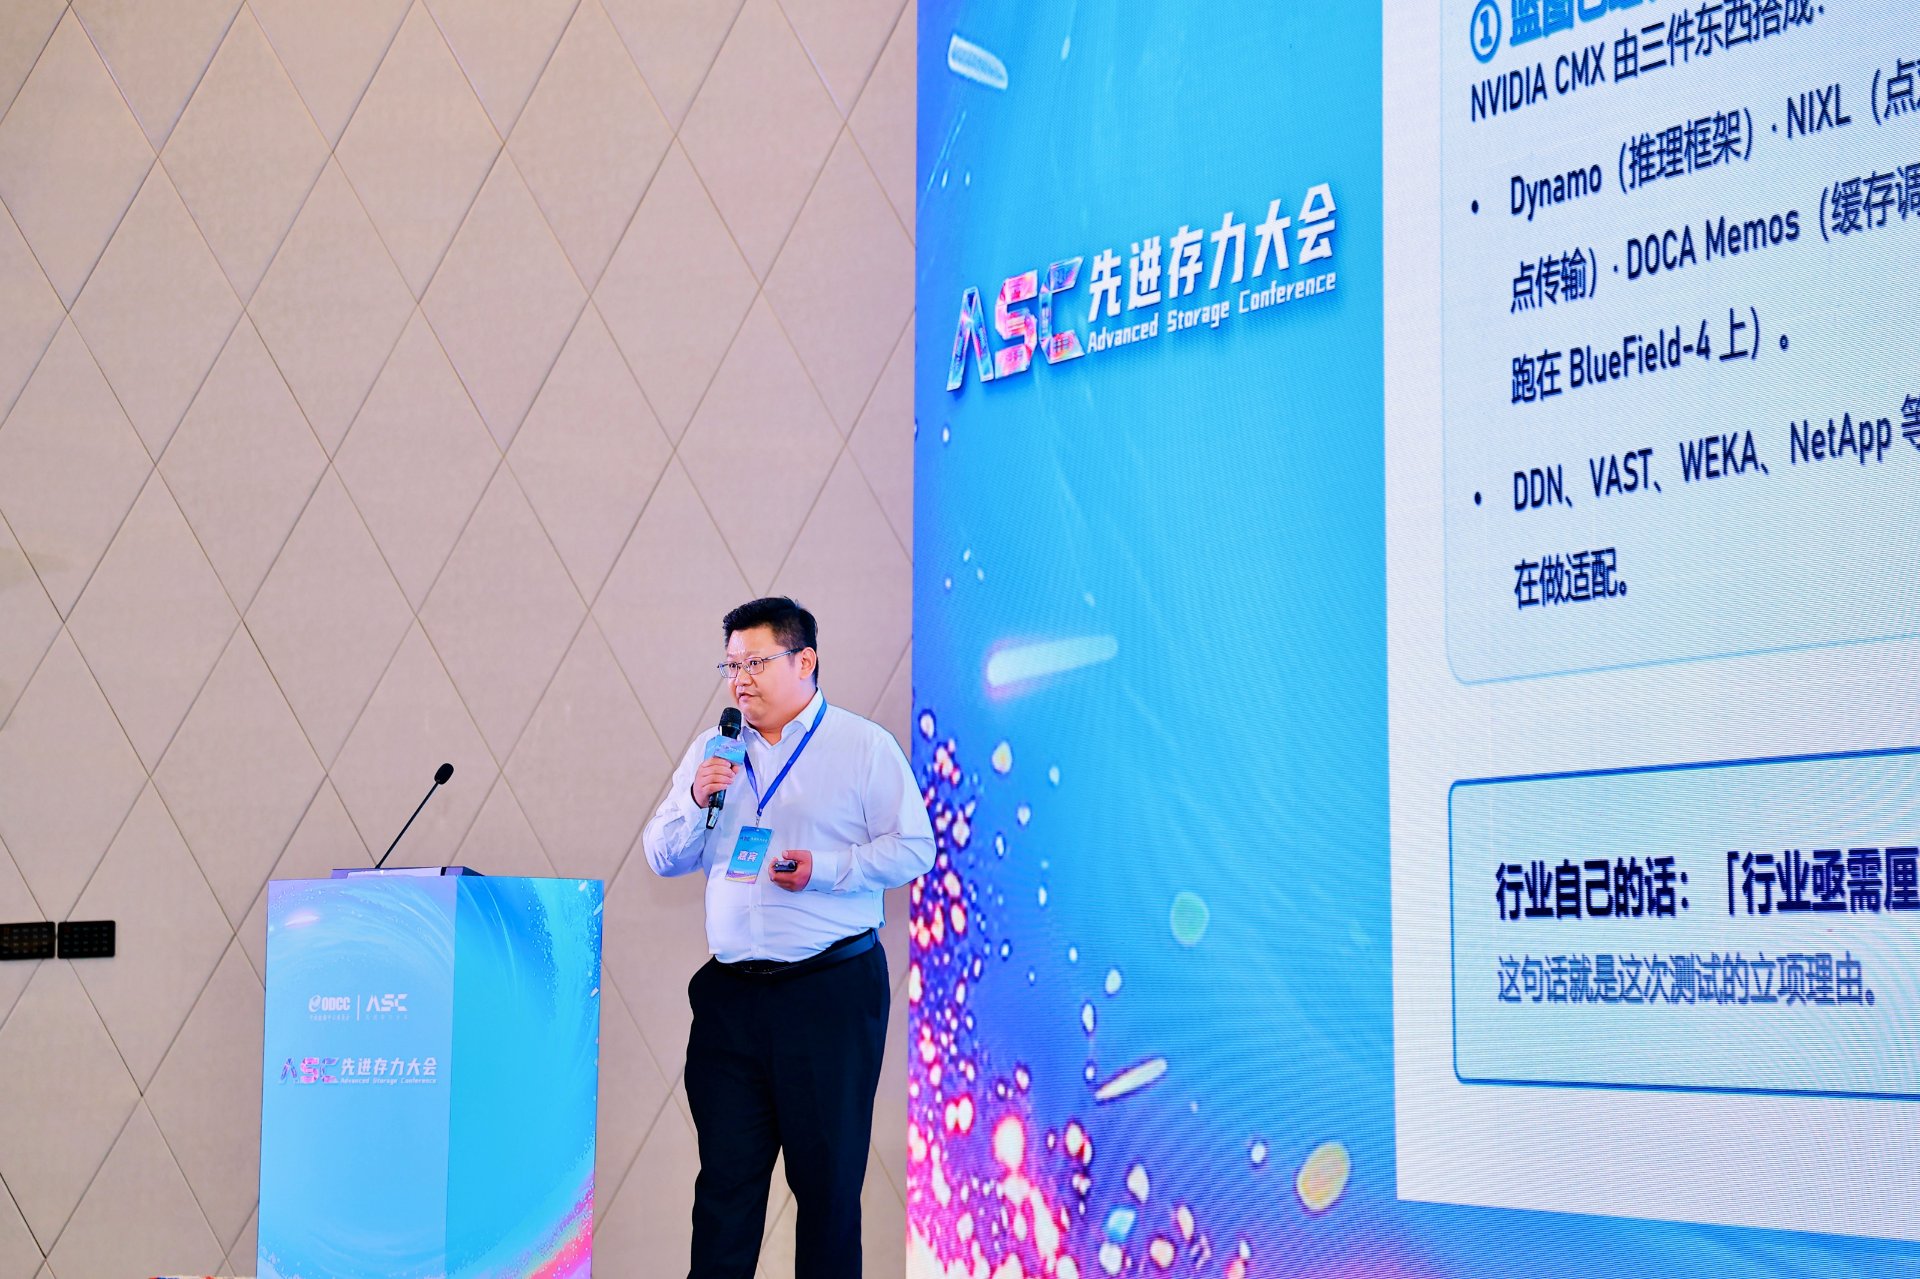
图:演讲现场——「NVIDIA CMX 三件套」分层蓝图页
配比经验也有了。行业通用思路是后端存储容量 ≈ 物理内存的 1000 倍,例如 13 TB HBM 的 NVL72,配套后端存储可规划 13 PB;成熟业务场景命中率约 85%,这是 DDN 客户实测的经验值。
缺的恰恰是这一块:把 KV Cache 真的从内存下沉一层,推理到底要付多少代价?这个关键数字,此前没有公开实测——而它恰恰是客户做预算时第一个要问的。
黄飞引了行业自己的一句话作为立题理由:
「行业亟需厘清 KV 缓存的核心价值,以及各类架构设计对缓存调度效率带来的实际影响。」
所以绿算技术做了一次实验,要回答三个问题:Q1 代价、Q2 换来、Q3 结果。测试用的是真实的推理引擎、真实的长会话负载——不是模拟,也不是理论推算。
一次"先让 8 倍"的实验
测试环境摆在明处:存储侧是绿算 GP7000 全闪 NVMe-oF 阵列(6×BlueField-3 DPU、12 条 200G 网络、24 块 7.68 TB 固态盘,构成 46.09 TB 的 NoF 池);计算侧 4 台 GPU 服务器,每台 2×Intel Xeon 6767P、8×RTX 6000D、1007 GiB DRAM;软件栈为 NVIDIA Dynamo + vLLM + Mooncake KV Store,模型是 DeepSeek-V4-Flash。
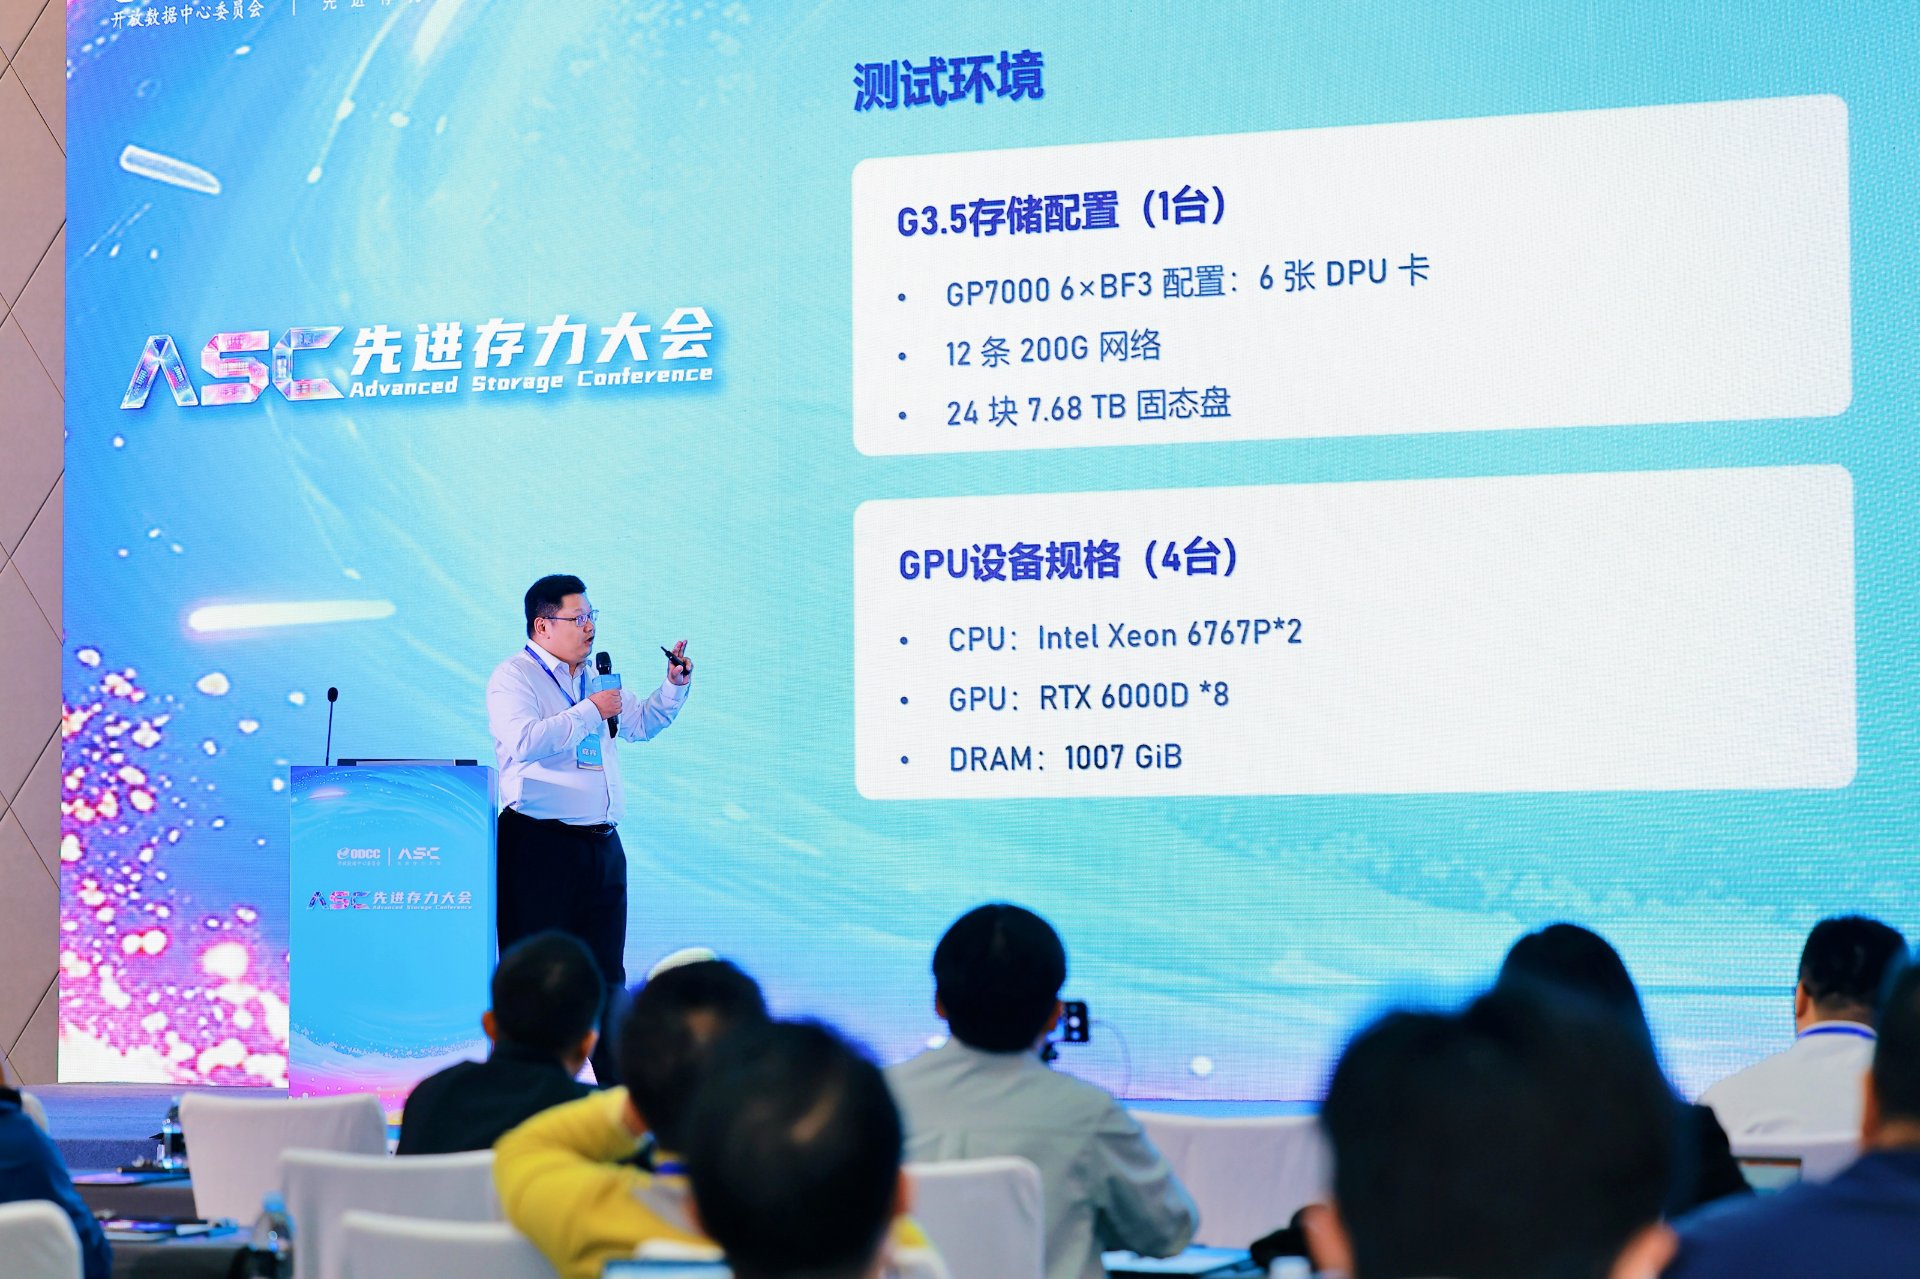
图:黄飞介绍测试环境——绿算 GP7000 存储配置与 GPU 设备规格
两组配置的唯一差别,是给内存留多少:
- 只用内存:KV 全部落在 DRAM,400 GiB 给满;
- 内存 + NoF 闪存池:DRAM 砍到 50 GiB,剩下的容量由 46.09 TB 全闪池补回来——内存只给了八分之一。
黄飞特意把这一点讲在前面:这不是"同样大小的内存再加一层盘",而是内存砍到 1/8,用全闪把容量补回来。后面每一个"打平",都建立在这个前提下。
对比的有效性,也不是靠叙述保证的,而是靠机器判据。两组跑的是完全相同的负载:写入缓存总次数 1,483,040 对 1,484,463(差 0.1%),读取总次数 308,672 对 309,732(差 0.3%),命中率一致,累计错误为 0。关键的一条是:纯内存组全程写了 1.49 TB 缓存,落到闪存上的字节数是 0.0 B——介质身份被确认,闪存组则实打实写入了 1.486 TB 增量。
如果内存给得一样多,那就变成谁内存大谁赢——没意义。
这是整场实验的方法论底色。
Q1 · 代价:内存少了八成,速度没有掉
第一问的答案,是黄飞全场唯一一句"我们没赢"。
七个并发档位,从 4 并发一路拉到 256 并发,每秒能做完的请求数,与纯内存方案相比的差距全部落在 −4.9% ~ +5.5% 之间;其中 256 并发一档,闪存方案反而高出 5.5%。
我们把闪存放进去——没有让推理变快,也没有让它变慢。这不是提升,是打平。
物理原因并不玄:一轮对话里,绝大部分时间花在"逐字生成"上,读缓存只占其中一小段,介质之间的差异被生成时间稀释掉了。所以"内存少了八倍,速度没有掉",是可以解释的,而不是运气。
黄飞自己也点破了这句话的价值:这是整场唯一一句「我们没赢」,但正因为这句是真的,后面两个答案,才有人信。
Q2 · 换来:430 GB → 46 TB
第二问的答案是一个倍数,但给它加了限定。
同样一套推理集群,能装下的缓存总量从 430 GB 提升到 46 TB,约 107 倍。
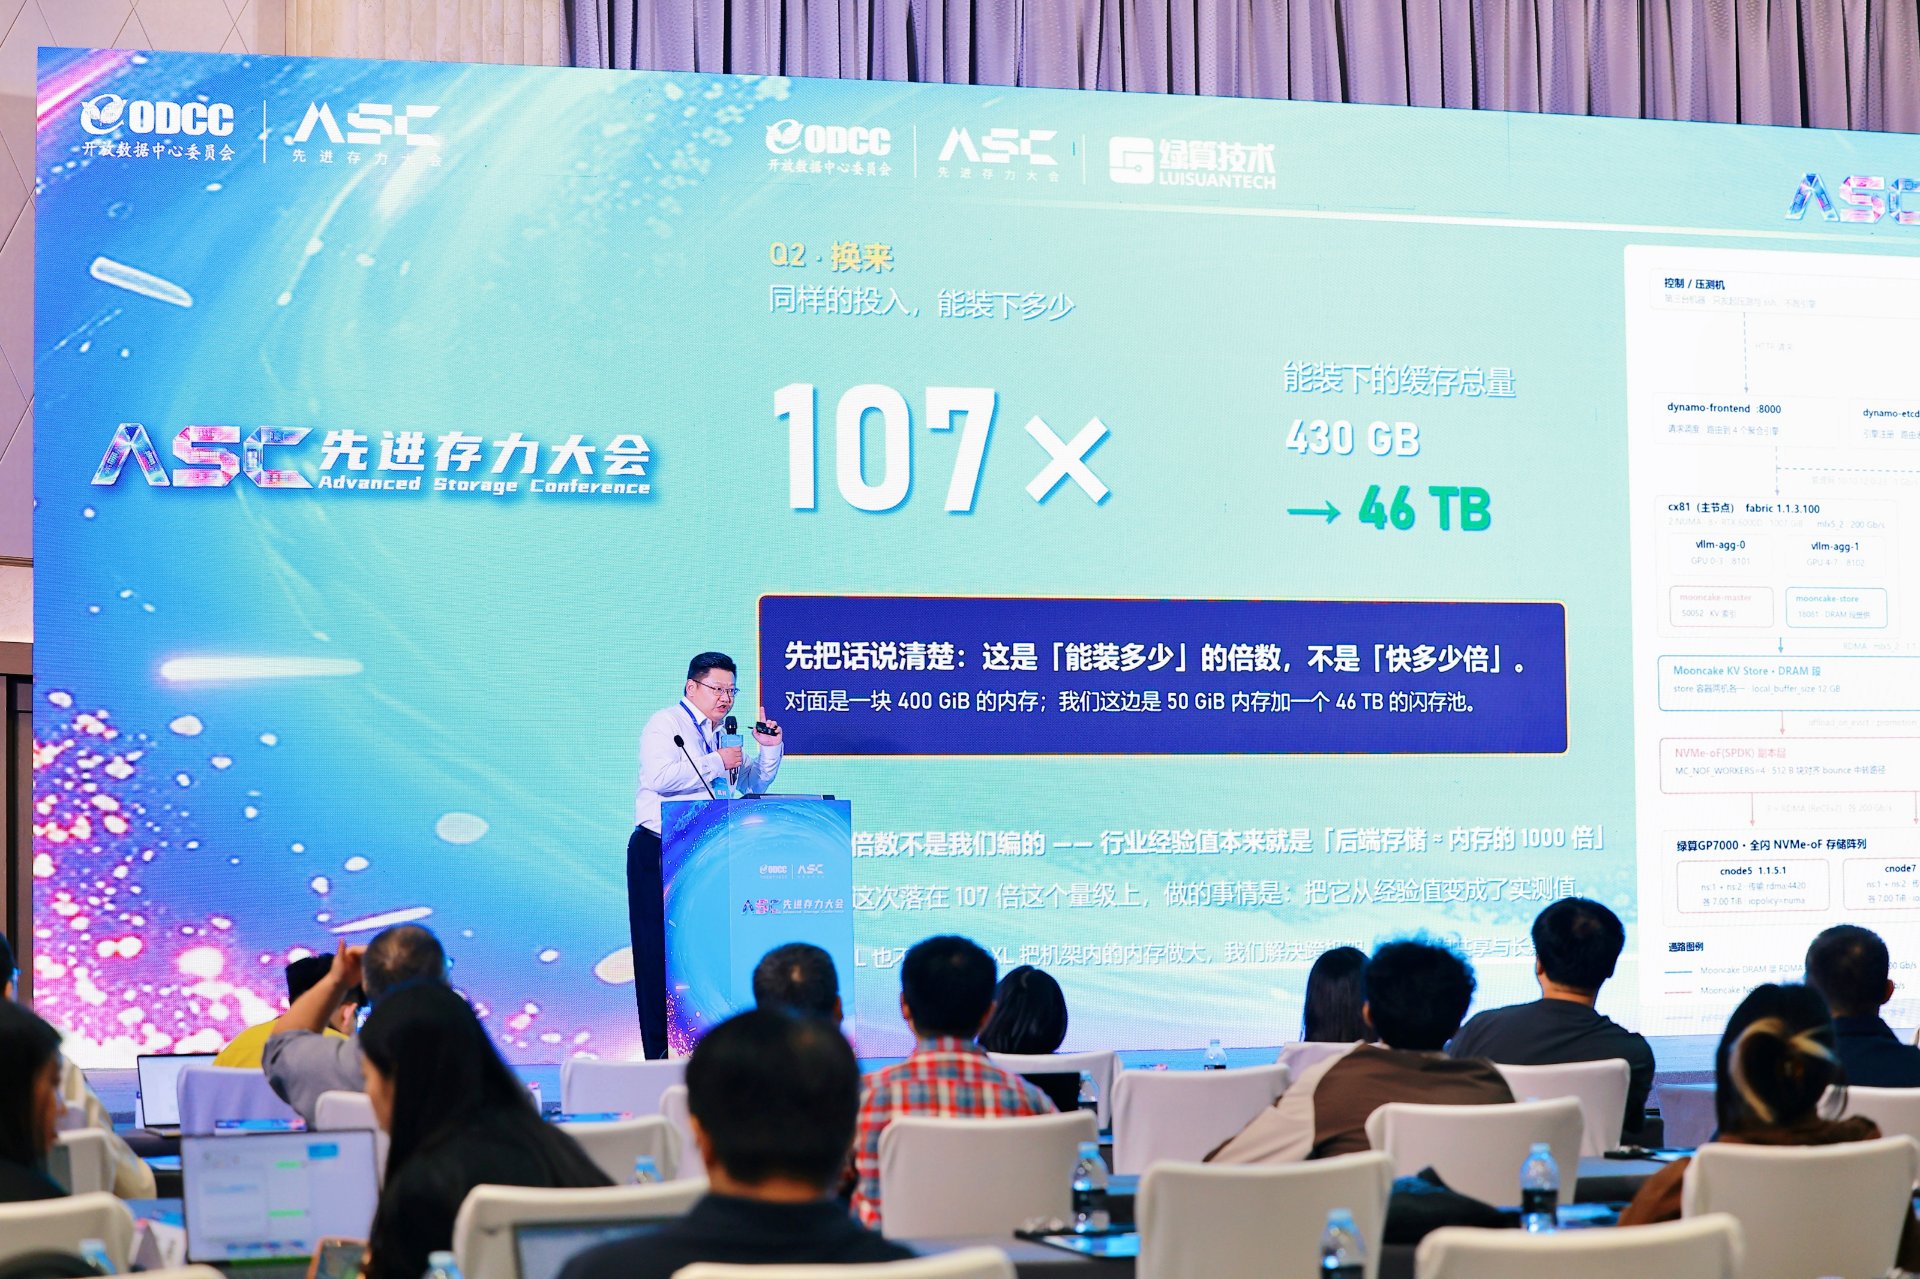
图:大屏上的 Q2 结论——107×,430 GB → 46 TB
先把话说清楚:这是"能装多少"的倍数,不是"快多少"的倍数。
对面是 400 GiB 的内存,这边是 50 GiB 内存加一个 46 TB 的闪存池。这个 107 倍也不是编出来的——行业经验值本来就是"后端存储 ≈ 内存的 1000 倍",这次做的事情,是把它从经验值变成实测值。同时它与 CXL 也不冲突:CXL 把机架内的内存做大,绿算解决的是跨机架、PB 级的共享与长期保存。
Q3 · 结果:分叉不在第一轮,在第八轮
第三问最像"跑分",但它给出的其实是一条曲线。
20 轮长会话压力测试、每轮强制输出 5,000 token:前七轮,两条曲线完全重合;第八轮开始分叉——正好是纯内存组被写满的那一刻。
- 到第 20 轮,命中率:0.85% 对 95.2%,相差 112 倍;
- 等第一个字要多久:246 秒 对 17 秒,差 14 倍;
- 这一轮总共要跑多久:727 秒 对 278 秒。
这不是压测口径上的差距,是用户真正能感觉到的差别。
而"崩掉之后为什么回不来",黄飞讲得很直白:一条会话的缓存不是一堆散块,而是一本接龙写的笔记,后一页必须接着前一页。腾地方的时候,被清掉的恰恰是第一页;第一页没了,后面全部作废,整条会话只能从头再来——重算、重写、更满、再重算。单轮写入量就这样从 50 GB 涨到 1,052 GB,越写越满,停不下来。
问题不在"腾地方",在腾错了对象。我们的做法是,把这件事从系统里拿掉。
闪存池是不会腾地方的容量——腾不了,就不会崩。所以在 50 轮实测里,命中率一路从 66% 涨到 98%,一次没掉;行业成熟业务命中率约 85%,长会话场景绿算实测在 95% 以上;按这次测试的量,要写满大约得 2,000 多轮。而同样的负载下,只用内存的方案第 20 轮就写满了,50 轮在算术上根本跑不完。
图:演讲现场,黄飞用实测数据回答"第几轮会崩"
把边界写在前面
演讲里有一段,是很多厂商会跳过的。
黄飞专门用一页 PPT 说明"这四条之外,请别引用我们的数据":
- GPU 是独占的。这次 GPU 只跑一个任务,它自带的缓存帮了忙;真实环境会被别的业务一起用,没有这份余量。
- 算力侧用的是偏弱的一组。算力越强、生成越快,读缓存占时间的比例会上升——这是判断,不是结论,正在补测。
- "打平"有前提。打平的是整轮吞吐,不代表"读一个字节的速度没差别",差别被生成时间稀释掉了。
- 只覆盖池化架构。仅适用于 NoF 共享闪存池,不覆盖本地盘,也不覆盖其他并行方案。
甚至连一个"对自己有利的意外"也主动解释掉了:测试中纯内存组从第 5 轮起命中率回升到 99.1%,原因是 GPU 自带缓存装下了 1,388 万个 token,而活跃会话只有 535 万——被 GPU 兜住了。但真实环境里,GPU 会被其他业务冲刷,没有这份余量。
把这一次当成"纯内存也够用",是我们明确反对的。
在一个人人都愿意挑对自己有利的数据来讲的场合,这种克制反而是最可信的部分。
让容量规划,第一次可以和性能规划分开做
三个问题答完,落到一句总结上:
- Q1 补上了行业缺的那块实测:下沉的代价 0.97–1.03×,最高并发还反超 5.5%——代价接近零;
- Q2 把"千倍配比"从经验值变成可验证的数据:430 GB → 46 TB,107 倍,同一套推理集群;
- Q3 让"第几轮会崩"从经验判断变成可计算的数:第 8 轮开始分叉,这个数可以提前算出来。
这次测试的价值,不在于证明我们快——我们确实没变快。而在于:行业一直在讨论"KV Cache 该怎么分层",却没人把"下沉一层要付多少代价"测出来。
这个数补上之后,容量规划第一次可以和性能规划分开做。大会反复讲的"以存强算、以存促算",这次给出的,是它一个可测量的版本。